Beste KI-Tools zum Lesen von Fachartikeln (2026) | Ponder.ing
 ·7/19/2026·10 Min. Lesezeit
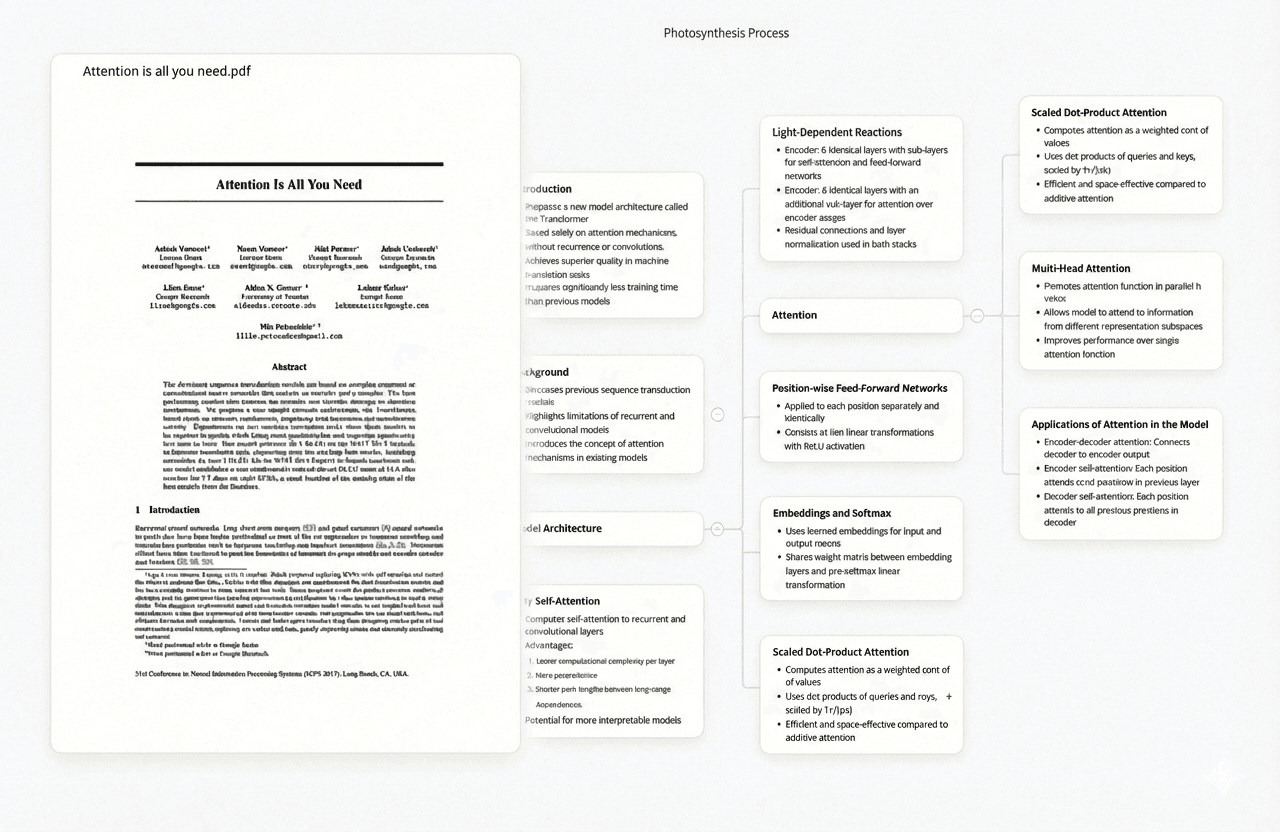
Ponder – Wenn Sie eine Sammlung lesen müssen, nicht nur ein einziges Paper
Das zeitaufwändigste Leseproblem in der akademischen Forschung ist nicht das Verstehen eines schwierigen Papers – es ist das Extrahieren dessen, was eine Sammlung von zwanzig, fünfzig oder zweihundert Papers über ein bestimmtes Thema aussagt. Ponder wurde für dieses Problem entwickelt. Sie laden eine Reihe von PDFs in ein Ponder-Projekt hoch und stellen dann Fragen zur gesamten Sammlung: „Welche Messinstrumente verwenden diese Studien?“ oder „Welche Papers beschreiben diesen Mechanismus anders als die Mehrheit?“ Das Ergebnis ist eine synthetisierte Antwort, die aus den relevanten Passagen aller hochgeladenen Papers gezogen wird, mit seitenweisen Zitaten, die die genaue Seitenzahl in jedem spezifischen Paper angeben.
Dies macht Ponder am nützlichsten später in einem Lesearbeitsablauf – nach dem Sammeln von Papers, nicht beim erstmaligen Lesen eines einzelnen unbekannten Papers. Für einen Forscher, der eine Literatursammlung zusammengestellt hat und versucht, einen Syntheseabschnitt zu schreiben, festzustellen, was bekannt ist, oder schnell eine übergreifende Frage zu beantworten, ohne alles neu zu lesen, reduziert Ponder das, was sonst Tage dauern würde, auf Stunden. Das seitenweise Zitationsmodell bedeutet, dass jede Antwort überprüfbar ist: Sie können direkt zur zitierten Seite springen, anstatt einen gesamten 30-seitigen Methodikabschnitt zu durchsuchen, um eine Behauptung zu bestätigen.
- Laden Sie eine Sammlung von PDFs hoch und stellen Sie gleichzeitig Fragen zu allen
- Seitenweise Zitate – genaue Seitenzahlen aus jedem Paper, nicht nur Dokumentenzuordnung
- Fragen Sie „Was sagen all diese Studien über X?“ und erhalten Sie eine synthetisierte Antwort in weniger als einer Minute
- Identifizieren Sie Papers, die dem Konsens in Ihrer Sammlung widersprechen, ohne jedes einzelne zu lesen
- Am effektivsten bei 5+ Papers; skaliert auf Hunderte ohne Beeinträchtigung der Zitationsgenauigkeit
- Pro-Projekt-Organisation – halten Sie die Papers eines Dissertationsprojekts von den Papers einer Literaturübersicht getrennt
SciSpace – Wenn Sie Hilfe beim Verstehen eines schwierigen Papers während des Lesens benötigen
SciSpace ist das stärkste Tool für das Leseverständnis innerhalb eines einzelnen Papers. Sein entscheidendes Merkmal ist die kontextbezogene KI-Unterstützung, die während des Lesens aktiviert wird: Markieren Sie einen unbekannten Begriff, eine statistische Methode oder eine dichte methodische Passage, und SciSpace erklärt es in einfacher Sprache unter Bezugnahme darauf, wie es in diesem spezifischen Paper erscheint. Für Doktoranden, die außerhalb ihres unmittelbaren Fachgebiets lesen – ein Biologe, der ökonometrische Methodik liest, ein Sozialwissenschaftler, der auf maschinelle Lernterminologie stößt – beseitigt diese In-Paper-Erklärung die Reibung des Kontextwechsels zu Google oder Lehrbüchern.
Die SciSpace-Leseoberfläche zeigt das Originalpaper neben einem KI-Assistenten-Panel. Sie können Fragen zu dem stellen, was Sie gerade lesen („Was zeigt diese Abbildung eigentlich?“, „Warum haben die Autoren diesen statistischen Test und nicht ANOVA verwendet?“) und erhalten Antworten, die im Text des Papers begründet sind. Das Tool generiert auch TLDR-Zusammenfassungen, extrahiert Schlüsselfragen, Methodik und Ergebnisse in einer strukturierten Ansicht und unterstützt das Stellen von Fragen über mehrere hochgeladene Dokumente hinweg – obwohl die Synthese über mehrere Papers hinweg weniger detailliert ist als in Ponder. Mit über 280 Millionen indizierten Papers können die meisten Papers direkt in SciSpace geöffnet werden, ohne sie hochzuladen.
- Markieren Sie einen beliebigen Begriff oder eine Passage für eine sofortige kontextbezogene Erklärung, die im Text des Papers begründet ist
- Das KI-Assistenten-Panel beantwortet Fragen zum geöffneten Paper, ohne die Leseansicht zu verlassen
- Strukturierte Zusammenfassungen, die Forschungsfrage, Methodik, Ergebnisse und Einschränkungen automatisch extrahieren
- 280M+ indizierte Papers – die meisten Papers können direkt geöffnet werden, ohne das PDF hochzuladen
- Zitationsexport nach Zotero, Mendeley und BibTeX direkt aus der Leseoberfläche
- Kostenloser Tarif verfügbar; Pro-Plan ab ca. 12 $/Monat für unbegrenzten Dokumentenzugriff
Elicit – Wenn Sie beim Lesen spezifische Daten aus Papers extrahieren müssen
Elicit fasst das Lesen als strukturierte Datenextraktion neu. Anstatt eine Paper-Erzählung zu lesen und Notizen zu machen, präsentiert Elicit Papers in einem tabellarischen Format, wobei jede Spalte einem von Ihnen definierten Feld entspricht – Stichprobengröße, Population, Intervention, Vergleich, primäres Ergebnis – und die KI füllt jede Zelle automatisch mit einem direkten Zitat aus dem Quelltext. Für systematische Leser, die Literaturübersichten erstellen, verwandelt dies das Lesen von einer offenen Verständnisaufgabe in eine strukturierte Extraktionsaufgabe und macht den Vergleich von Methoden über viele Papers hinweg zur primären Leseaktivität.
Das direkte Zitatmodell ist entscheidend für seine Zuverlässigkeit: Elicit fasst nicht aus dem Gedächtnis zusammen, sondern findet und zitiert die relevante Passage, sodass Sie jeden extrahierten Wert durch Lesen des zitierten Textes überprüfen können. Für Forscher, die Papers nach spezifischen Informationen lesen müssen – sei es eine Dosis, eine Effektgröße, eine Nachbeobachtungszeit – ist Elicits Extraktionsraster nachweislich schneller als offenes Lesen. Für Forscher, die narrative Argumente und theoretische Grundlagen verstehen müssen, ist es weniger nützlich, da das Rasterformat das verbindende Gewebe, wie ein Paper seine Behauptungen entwickelt, verwirft.
- Definieren Sie benutzerdefinierte Extraktionsspalten und Elicit füllt diese mit direkten Zitaten aus jedem Paper
- Vergleichen Sie Methodik, Stichprobenmerkmale und Ergebnisse aus Dutzenden von Papers in einer Ansicht
- Direkte Zitatüberprüfung – sehen Sie die genaue Passage, die für jede extrahierte Tatsache verwendet wurde
- Funktioniert für systematisches Lesen in jeder akademischen Disziplin – nicht auf Medizin oder Biowissenschaften beschränkt
- Bis zu 5.000 Papers mit vollständiger Extraktion im Pro-Plan
- Exportieren Sie extrahierte Tabellen als CSV zur Integration mit Referenzmanagern oder Analysetools
Semantic Scholar – Wenn Sie Kontext für ein Paper benötigen, bevor Sie es lesen
Semantic Scholar bietet KI-generierte TLDRs, Zusammenfassungen des Zitationskontexts und Zitationseinfluss-Scores, die Forschern helfen zu entscheiden, welche Papers in einer Leseliste es wert sind, vollständig gelesen zu werden, und welche überflogen oder übersprungen werden können. Der KI-generierte TLDR ist eine einzeilige Zusammenfassung, die aus dem Abstract und der Einleitung des Papers generiert wird – genau für gut strukturierte empirische Papers, weniger zuverlässig für theoretische oder Übersichtsartikel mit komplexer Rahmung. Die Zitationskontextfunktion zeigt, wie nachfolgende Papers eine Arbeit zitiert haben und ob diese Zitate Zustimmung, Ablehnung oder methodische Verwendung widerspiegeln.
Für Lesegeschwindigkeit und Priorisierung ist Semantic Scholar am nützlichsten am Anfang des Lesearbeitsablaufs: Sie entscheiden, welche von fünfzig Suchergebnissen eine vollständige Textlesung verdienen. Das vollständige Leseerlebnis von Semantic Scholar ist begrenzt – Sie können innerhalb der Paper-Oberfläche keine Anmerkungen machen, hervorheben oder Fragen stellen. Es fungiert eher als Forschungstriage-Tool denn als Leseumgebung. Die Visualisierung „Connected Papers“ (ein separates Tool, das nicht direkt zu Semantic Scholar gehört) baut auf den Zitationsdaten von Semantic Scholar auf, um zu zeigen, welche Papers einem Ausgangspapier am engsten verwandt sind, und hilft Lesern, grundlegende Arbeiten zu identifizieren, die priorisiert werden sollten.
- KI-generierte TLDRs für über 200 Millionen Papers – schnelle Zusammenfassungen auf Paper-Ebene zur Lesepriorisierung
- Der Zitationskontext zeigt, wie ein Paper von nachfolgenden Arbeiten zitiert wurde und ob diese Zitate bestätigen oder widerlegen
- Der Zitationseinfluss-Score deutet darauf hin, wie grundlegend oder weit verbreitet ein Paper in seinem Bereich ist
- Die Klassifizierung von Forschungsgebieten hilft Lesern zu verstehen, welche Papers Mainstream-Positionen gegenüber Grenzpositionen repräsentieren
- Kostenlos und ohne Ratenbegrenzung – kein Konto für den grundlegenden Zugriff erforderlich
- API-Zugriff zur Integration von Zitations- und Zusammenfassungsdaten in benutzerdefinierte Lesetools oder Dashboards
Claude – Wenn Sie eine tiefgehende Analyse eines einzelnen komplexen Papers benötigen
Claude (Anthropic's KI-Assistent) ist das leistungsfähigste Allzweckwerkzeug, um offene Fragen zu einem einzelnen hochgeladenen Paper zu stellen. Im Gegensatz zu domänenspezifischen Tools kann Claude theoretische Argumente behandeln, logische Konsistenz bewerten, implizite Annahmen identifizieren und strukturierte Kritiken generieren – Aufgaben, die Argumentation über Inhalte erfordern, anstatt vordefinierte Datenfelder zu extrahieren. Für das Lesen eines dichten Papers in einem unbekannten Bereich, eines herausfordernden theoretischen Textes oder eines Papers, bei dem Sie das Argument hinterfragen möchten, anstatt Daten zu extrahieren, bewältigt Claude im Pro-Plan (der große Kontextfenster erlaubt) die volle Komplexität des wissenschaftlichen Schreibens.
Der praktische Arbeitsablauf ist: Laden Sie das Paper als PDF herunter, laden Sie es in eine Claude-Konversation hoch und stellen Sie spezifische analytische Fragen. Claude bewältigt all dies gut – „Erklären Sie die Methodik jemandem, der Regression, aber keine Bayes'schen Ansätze kennt“, „Identifizieren Sie die Annahmen, die in dieser Literatur am umstrittensten sind“, „Worauf würde sich ein Kritiker der Schlussfolgerungen dieses Papers konzentrieren?“ Die Einschränkung ist der Umfang: Claude funktioniert gut mit einem Paper oder einer kleinen Anzahl von Papers innerhalb der Kontextgrenze, bietet aber nicht die Synthese über mehrere Papers mit Quellenangaben, die ein spezielles Multi-Dokument-Tool wie Ponder bietet. Mit 20 $/Monat für Claude Pro sind die Kosten vergleichbar mit speziellen Forschungslese-Tools.
- Offene Paper-Fragen und -Antworten, einschließlich theoretischer Argumentation, Annahmenanalyse und Kritikerstellung
- PDFs direkt hochladen – verarbeitet Papers bis zur Kontextfenstergrenze ohne Verlust der Zusammenfassung
- Erklärt die Methodik auf jedem von Ihnen angegebenen Niveau – von „einem Anfänger erklären“ bis „mit Bayes'schen Alternativen vergleichen“
- Generiert strukturierte Lesnotizen, Zusammenfassungen in bestimmten Formaten oder Listen von Folgefragen
- Keine Domänenbeschränkung – gleichermaßen nützlich in Naturwissenschaften, Sozialwissenschaften und Geisteswissenschaften
- Claude Pro für 20 $/Monat; kostenloser Tarif hat niedrigere Kontextgrenzen und kann lange Papers abschneiden
Adobe Acrobat AI – Wenn Sie bereits in Acrobat sind und schnelle Zusammenfassungen benötigen
Der Adobe Acrobat AI Assistant ist in Acrobat Pro integriert und adressiert eine spezifische Workflow-Realität: Viele Forscher nutzen Acrobat bereits als primären PDF-Reader, weil ihre Institution eine Acrobat-Lizenz bereitstellt, weil sie dort PDFs kommentieren oder weil ihr Fachgebiet PDF-Formulare und komplexe Dokumente verwendet, die Acrobat am besten verarbeitet. Für diese Forscher bietet der Acrobat AI Assistant KI-Zusammenfassungen, Dokumenten-Q&A und die Extraktion von Schlüsselpunkten innerhalb des Tools, das sie bereits verwenden, ohne separate Software herunterladen zu müssen.
Das Leseerlebnis in Acrobat ist hervorragend – Anmerkungswerkzeuge, Formularausfüllung, Signatur und Dokumentenvergleich sind neben den KI-Funktionen alle verfügbar. Die KI-Funktionen sind kompetent für grundlegende Zusammenfassungen und Q&A zu einzelnen Dokumenten, erreichen aber nicht die Tiefe von SciSpace für das Leseverständnis innerhalb eines Papers, den Umfang von Ponder für die Synthese über mehrere Papers hinweg oder die analytische Tiefe von Claude für komplexe Denkaufgaben. Sein Vorteil ist die Integration: Wenn Ihr Lesearbeitsablauf bereits auf Acrobat zentriert ist, fügen die KI-Funktionen einen hohen Mehrwert hinzu, ohne den Workflow zu stören. Acrobat Pro ist über Adobe Creative Cloud für 25,99 $/Monat oder über institutionelle Lizenzen erhältlich, die viele Universitäten bereitstellen.
- KI-Assistent direkt in Acrobat Pro integriert – keine separate App oder Konto erforderlich
- Dokumentenzusammenfassungen, Extraktion von Schlüsselpunkten und Q&A zu einzelnen PDF-Dokumenten
- Vollständiges Acrobat-Anmerkungswerkzeug neben KI-Funktionen – Hervorheben, Kommentieren und Lesezeichen in einer Ansicht
- Funktioniert mit gescannten PDFs nach der OCR-Verarbeitung, nicht nur mit textnativen Dateien
- Institutionelle Lizenzen über die meisten IT-Abteilungen von Universitäten erhältlich
- 25,99 $/Monat Acrobat Pro (inklusive AI Assistant); viele Universitäten stellen es als Teil der Adobe-Campuslizenz bereit
Humata AI – Wenn Sie schnelle Fragen und Antworten zu mehreren hochgeladenen Dokumenten benötigen
Humata AI ist ein Dokumenten-Q&A-Tool, das mehrere hochgeladene PDFs verarbeitet und Fragen zu allen innerhalb eines einzigen Arbeitsbereichs ermöglicht. Seine Oberfläche ist einfacher als die von Ponder – weniger auf Synthese und mehr auf direkte Beantwortung von Fragen ausgerichtet – bietet aber Multi-Dokumenten-Q&A mit Quellhervorhebung zu einem niedrigeren Preis als viele Alternativen. Für Forscher, die fragen möchten „Welches dieser fünf Papers diskutiert Einschränkungen der Stichprobengröße?“ oder „In welchem Jahr wurde jede dieser Studien durchgeführt?“, ohne jedes Paper einzeln zu öffnen, erledigt Humata dies effizient.
Die Quellenangaben von Humata heben die relevante Passage im Originaldokument neben der Antwort hervor, was eine schnelle Überprüfung ermöglicht. Das Tool ist primär für die Dokumentenprüfung und Q&A konzipiert und nicht für die akademische Forschungssynthese: Es wird häufig in rechtlichen, Compliance- und Geschäftskontexten eingesetzt, wo die Geschwindigkeit der Dokumentenprüfung wichtiger ist als eine tiefgehende Synthese über mehrere Papers hinweg. Für akademische Leser, die eine moderate Anzahl von Papers (typischerweise 5–20) schnell verarbeiten müssen und eine leichtere Multi-Dokumenten-Q&A-Oberfläche als Ponder wünschen, ist Humata eine praktische Wahl zu einem niedrigeren Preis. Sein kostenloser Tarif verarbeitet kleine Dokumentensätze.
- Multi-Dokumenten-Upload mit Q&A über alle Dokumente in einem Arbeitsbereich gleichzeitig
- Quellhervorhebung zeigt die relevante Passage im Original-PDF neben jeder Antwort
- Einfache Benutzeroberfläche – schnellere Einarbeitung als bei forschungsspezifischen Tools wie Ponder oder Elicit
- Geeignet für die schnelle Dokumentenprüfung von moderaten Paper-Sets (typischerweise 5–20 Papers)
- Kostenloser Tarif: begrenzte Seiten pro Monat; kostenpflichtige Pläne ab 9,99 $/Monat für größere Dokumentensätze
- Wird in rechtlichen, Compliance- und akademischen Kontexten verwendet – vielseitig für gemischte Dokumenten-Workloads
Häufig gestellte Fragen
Was ist das beste KI-Tool zum Lesen von Forschungsarbeiten?
Es hängt davon ab, welches Leseproblem Sie lösen möchten. Für das Verständnis eines einzelnen schwierigen Papers bietet SciSpace die beste Unterstützung für das In-Paper-Verständnis. Für die Synthese über eine Sammlung von Papers bietet Ponder die beste Multi-Paper-Q&A mit seitenweisen Zitaten. Für die Extraktion spezifischer strukturierter Daten aus Papers ist Elicit am präzisesten. Für tiefgehende analytische Überlegungen zu einem Paper-Argument beantwortet Claude offene akademische Fragen gut. Die meisten Forschungsabläufe profitieren in verschiedenen Phasen von mehr als einem Tool.
Kann KI Forschungsarbeiten genau lesen?
KI-Tools sind zuverlässig für die Informationsgewinnung aus gut strukturierten empirischen Arbeiten – das Auffinden von Stichprobengrößen, Methoden, Ergebnissen und angegebenen Schlussfolgerungen –, erfordern jedoch eine Überprüfung für nuancierte Interpretationen, theoretische Behauptungen und die Synthese über mehrere Papers hinweg. Jedes KI-Tool, das Quellen zitiert, kann mit dem Original überprüft werden: Überprüfen Sie die zitierte Passage, bevor Sie die extrahierte Behauptung in Ihrer eigenen Arbeit verwenden. Papers mit ungewöhnlicher Formatierung, gescannte PDFs ohne OCR oder starke mathematische Notation können zu minderwertigen KI-Zusammenfassungen führen. Für kritische Entscheidungen betrachten Sie die KI-Unterstützung als ein Werkzeug zur Beschleunigung des Lesens, nicht als eine maßgebliche Zusammenfassung.
Ist SciSpace oder Ponder besser für Literaturübersichten?
Sie adressieren unterschiedliche Phasen. SciSpace ist besser in der Phase des individuellen Lesens von Papers: das Verstehen unbekannter Methoden, das Erhalten von Erklärungen im Text und das Aufbauen eines Verständnisses des Inhalts jedes Papers. Ponder ist besser in der Phase der Synthese über mehrere Papers hinweg: Sobald Sie eine Sammlung von Papers haben, fragen Sie, was sie gemeinsam aussagen, identifizieren Widersprüche und generieren Beweise für ein Argument. Ein Literaturübersicht-Workflow profitiert von beiden: SciSpace für das effiziente Lesen einzelner Papers, Ponder für die Synthese über die zusammengestellte Sammlung.
Siehe auch: Wie man Forschungsartikel mit KI zusammenfasst | Beste KI-Forschungstools für Studierende | Wie man eine Literaturrecherche mit KI schreibt